PDF RTF 변환기
PDF RTF 변환기는 PDF의 텍스트를 거의 어디서나 편집할 수 있는 Rich Text Format 문서로 다시 만들어 줍니다. 모든 작업이 내 기기에서 이루어지므로 파일은 기기 밖으로 나가지 않습니다.
변환은 이 기기에서 이루어집니다. 파일은 어디에도 업로드되지 않습니다.
사용 방법
PDF 넣기
PDF 하나 또는 최대 20개를 한꺼번에 선택하세요. 암호가 걸린 파일이면 먼저 기기에서 암호를 묻습니다.
미리보기 확인
페이지를 넘기며 원본과 RTF 미리보기를 비교하고, 레이아웃 유지와 깔끔한 문서 중 하나를 고르세요.
.rtf 저장
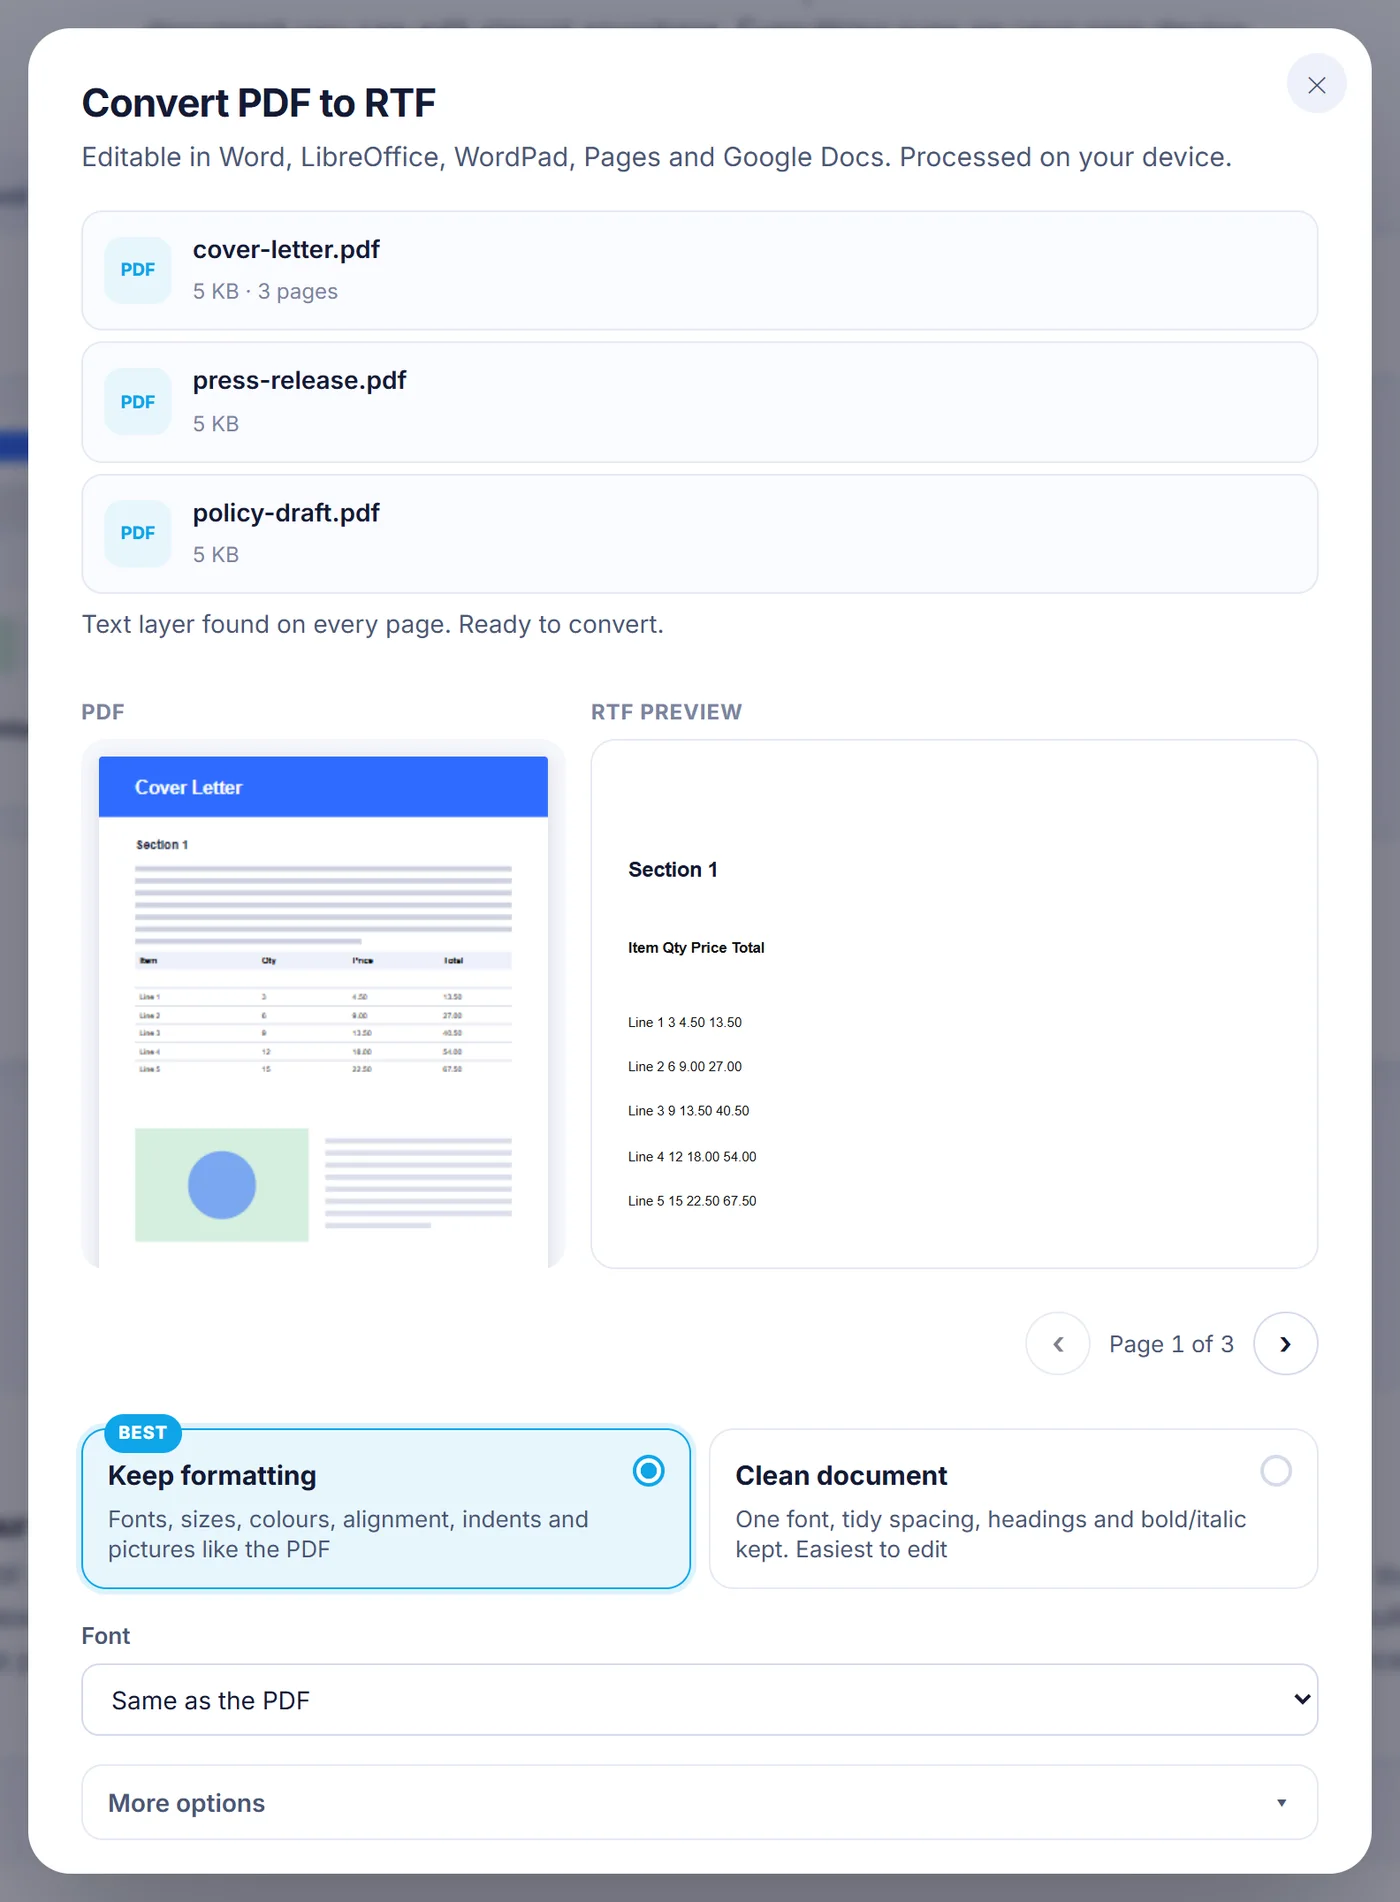
버튼을 누르고 진행률 표시줄이 끝나면 결과를 다운로드하거나, 변환된 모든 파일을 ZIP으로 한 번에 받으세요.
DOCX 대신 RTF를 선택하는 이유
Rich Text Format은 일반 텍스트 기반의 오래된 문서 형식이며, 바로 그 오래됨이 가장 큰 강점입니다. RTF 파일은 Microsoft Word, LibreOffice Writer, Apple Pages, TextEdit, WordPad, Google Docs에서 열리고, 구버전 프로그램에서도 문제없이 열립니다. 상대방이 어떤 프로그램을 쓰는지 모르는 상태에서 PDF의 편집 가능한 사본을 넘겨야 하거나, RTF만 가져올 수 있는 오래된 시스템에 문서를 넣어야 한다면 PDF RTF 변환이 가장 안전한 선택입니다.
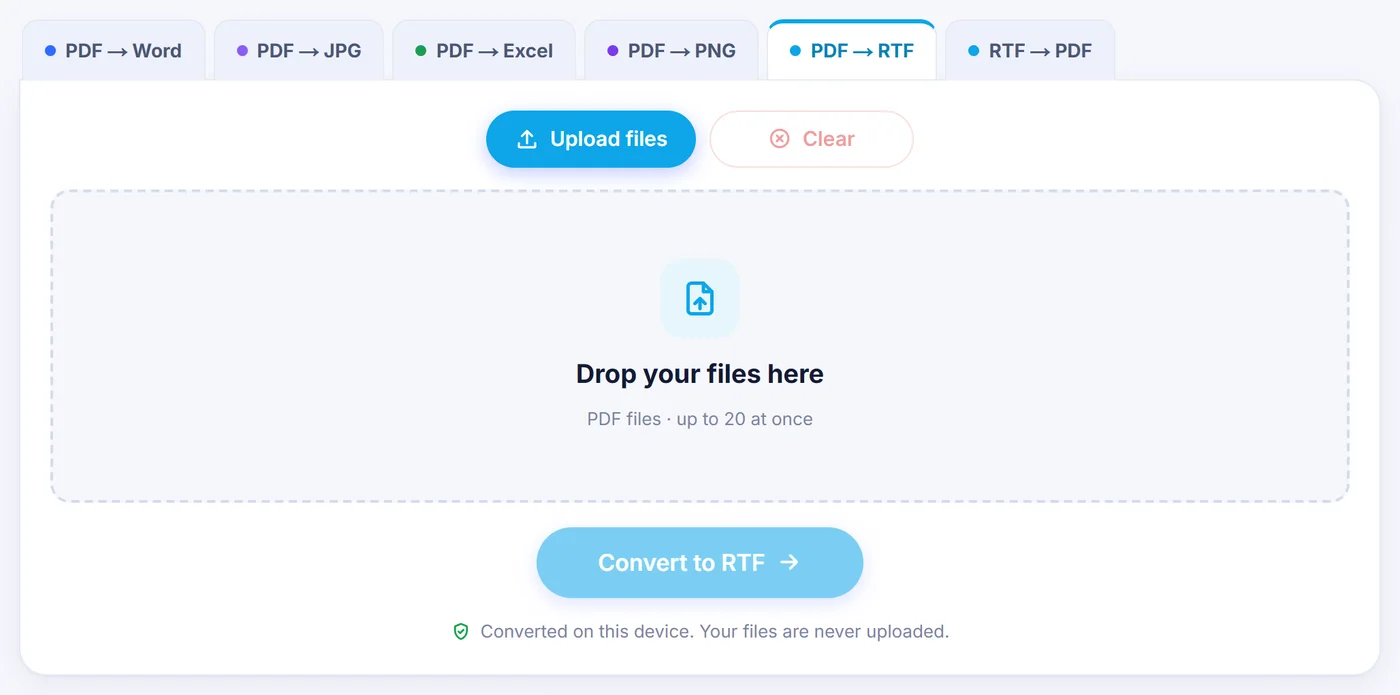
이 사이트에서 PDF RTF 변환이 이루어지는 방식
PDF는 글자를 페이지 위의 정확한 위치에 저장할 뿐, 단락이 무엇인지는 전혀 모릅니다. 변환기는 모든 텍스트 조각을 글꼴, 크기, 색상과 함께 읽어 들이고, 같은 기준선을 공유하는 조각을 한 줄로 묶은 다음, 줄 간격과 들여쓰기, 글머리 기호, 문장 끝을 살펴 단락이 어디서 시작하는지 판단합니다. 단락이 왼쪽 정렬인지, 가운데 정렬인지, 오른쪽 정렬인지, 양쪽 정렬인지도 알아내어, 떠다니는 텍스트 상자가 아니라 실제 RTF 단락으로 기록합니다. 그래서 결과물에 글을 입력하면 자연스럽게 다시 흐릅니다.
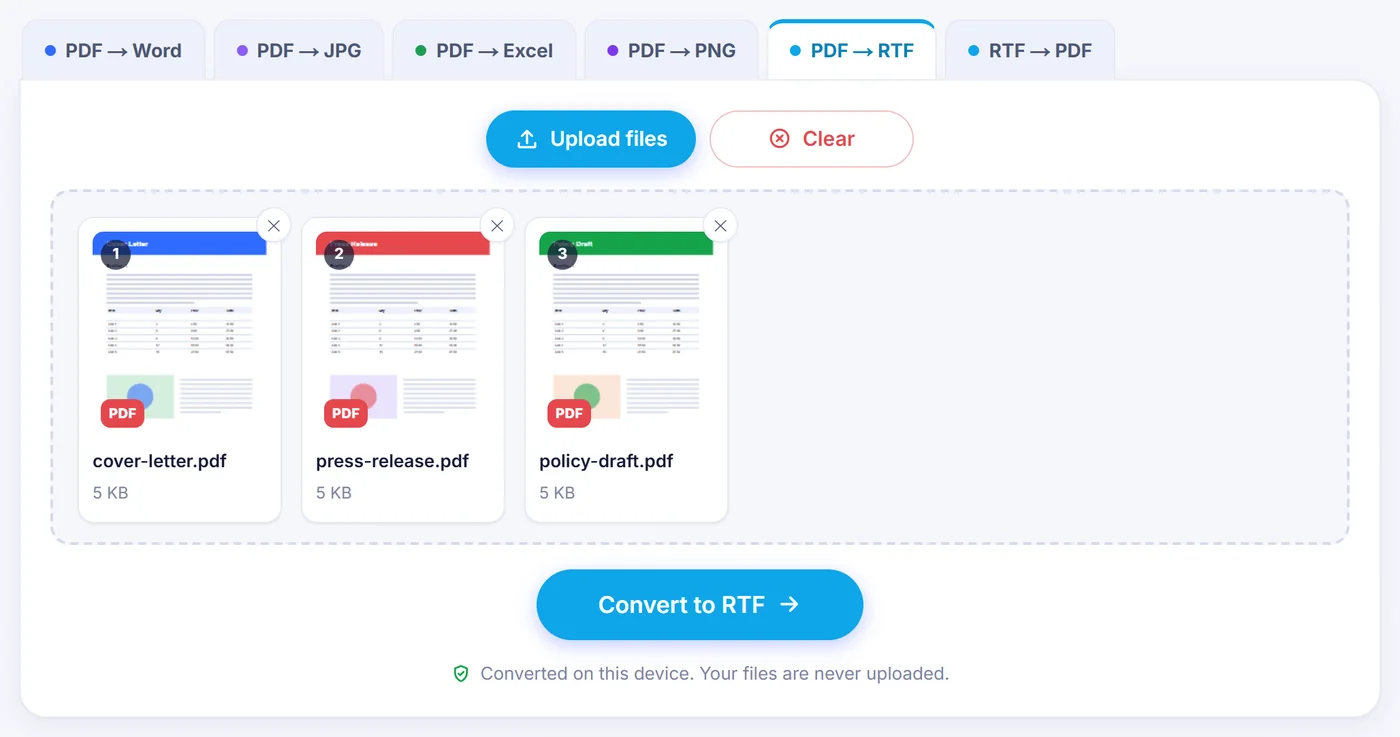
파일을 추가하면 PDF 페이지의 축소판과 RTF 실시간 미리보기가 나란히 놓인 설정 창이 열립니다. 변환을 시작하기 전에 페이지를 넘겨 가며 각 페이지가 어떻게 나올지 확인할 수 있습니다.
두 가지 출력 스타일
- ‘Keep formatting’(서식 유지, 기본값)은 글꼴, 크기, 글자 색, 정렬, 들여쓰기, 줄 간격, 그림을 그대로 가져오므로 문서가 PDF와 거의 비슷하게 보입니다.
- ‘Clean document’(깔끔한 문서)는 글꼴 하나와 단정한 간격, 단순한 제목 크기를 사용하되 굵게, 기울임, 제목 구조는 유지합니다. 이 모드에서는 글자 색이 제거됩니다. 원본의 모양을 재현하기보다 텍스트를 다시 쓸 계획이라면 이쪽을 선택하세요.
알아 두면 좋은 옵션
- ‘Pages’(페이지): PDF가 하나일 때는 1-3, 8이나 10-처럼 범위를 입력해 일부만 변환할 수 있습니다.
- ‘Font’(글꼴): PDF에 지정된 글꼴을 그대로 쓰거나, 전부 Calibri, Arial, Times New Roman, Georgia, Cambria, Verdana, Courier New 중 하나로 바꿀 수 있습니다. RTF는 글꼴 자체가 아니라 글꼴 이름만 저장하므로, 읽는 사람의 컴퓨터에 없는 글꼴은 비슷한 글꼴로 대체됩니다. 같은 이유로 Helvetica처럼 PDF에서 흔한 글꼴은 Arial로 매핑됩니다.
- ‘Detect headings’(제목 감지): 크거나 굵은 제목 줄이 실제 제목 스타일로 바뀌어, Word의 탐색 창과 자동 목차가 바로 작동합니다.
- ‘Keep page breaks’(페이지 나누기 유지): PDF의 각 페이지가 새 페이지에서 시작합니다. 끄면 페이지 끝에서 잘렸던 문장이 다시 하나로 이어집니다.
- ‘Join hyphenated words’(하이픈으로 나뉜 단어 합치기), ‘Keep web links clickable’(웹 링크 클릭 가능하게 유지), ‘Keep text colours’(글자 색 유지), ‘Include pictures’(그림 포함)는 각각 따로 켜고 끌 수 있습니다.
- ‘Remove headers, footers and page numbers’(머리글, 바닥글, 페이지 번호 제거)는 대부분의 페이지 위아래에 반복되는 줄을 없애 주므로, 긴 보고서에서 일일이 지우는 수고를 크게 덜어 줍니다.
선택한 설정은 페이지 범위를 제외하고 다음 방문을 위해 이 브라우저에 기억됩니다.
그대로 옮겨지는 것과 달라질 수 있는 것
본문 텍스트, 굵게와 기울임, 위 첨자와 아래 첨자, 글자 색, 웹 링크와 이메일 링크, 그림은 모두 RTF에 기록됩니다. 글머리 기호 항목과 번호 매기기 항목은 자동 목록이 아니라 기호나 번호를 텍스트로 포함한 별도의 단락이 됩니다. 사진은 JPEG로 삽입되고, 투명도가 있는 이미지는 PNG로 유지됩니다. 매우 큰 이미지는 파일 크기를 관리할 수 있도록 긴 변 기준 최대 1800픽셀로 축소되며, 괘선이나 점 같은 아주 작은 조각은 제외됩니다. 악센트가 붙은 글자와 비라틴 문자는 유니코드로 저장되고, 오른쪽에서 왼쪽으로 쓰는 단락은 그에 맞게 표시됩니다.
표는 편집 가능한 표 격자로 다시 만들어지지 않습니다. 셀은 열 사이에 탭 간격이 들어간 텍스트 줄로 옮겨집니다. 잡지처럼 여러 단으로 된 레이아웃은 하나의 단으로 이어집니다. 벡터 윤곽선으로 그려진 텍스트(로고나 일부 내보낸 디자인에서 흔함)는 실제 텍스트가 아닙니다. 그런 도형만으로 이루어진 페이지는 스캔한 페이지처럼 처리되고, 일반 텍스트 옆에 있는 윤곽선 로고는 그냥 옮겨지지 않습니다. 실제 텍스트 뒤에서 페이지 전체를 덮는 장식용 배경은 의도적으로 제외됩니다.
스캔한 PDF와 OCR
파일을 열면 도구가 페이지에 텍스트 레이어가 있는지 확인하고(첫 번째 PDF의 처음 60페이지), 텍스트 레이어가 없는 페이지가 몇 개인지 알려 줍니다. 그런 페이지에 대해서는 세 가지 처리 방식 중 하나를 고를 수 있습니다.
- ‘Recognise text (OCR)’(텍스트 인식): 페이지를 이미지로 렌더링한 뒤 기기에서 실행되는 OCR 엔진이 읽어 냅니다. 언어는 브라우저 설정에 따라 미리 선택되며, 루마니아어, 독일어, 러시아어, 그리스어, 아랍어, 히브리어, 중국어, 일본어, 한국어를 포함한 38개 언어 중 어느 것으로든 바꿀 수 있고, 영어는 항상 두 번째 언어로 추가됩니다. 정확도 설정에 따라 150, 220, 300dpi로 렌더링되며, 작은 글씨에는 가장 높은 값을 쓰세요.
- ‘Keep as picture’(그림으로 유지): 페이지 전체가 이미지로 RTF에 들어갑니다. 텍스트와 함께 보관만 하면 되는 서식이나 도면에 유용합니다.
- ‘Skip’(건너뛰기): 해당 페이지는 결과에서 제외됩니다.
어떤 언어로 OCR을 처음 실행하면 그 언어의 데이터 파일(약 2~15MB)이 한 번만 다운로드된 뒤 브라우저에 캐시됩니다. PDF 자체는 여전히 어디에도 전송되지 않습니다.
여러 PDF를 한꺼번에 변환하기
한 번에 최대 20개의 PDF를 추가할 수 있습니다. 모든 파일은 같은 설정으로 차례대로 변환되고, 진행률 표시줄에 지금 어떤 파일의 몇 번째 페이지를 처리 중인지 표시됩니다. 결과 파일의 이름은 원본 PDF를 따릅니다. 예를 들어 contract.pdf는 contract.rtf가 되고, 두 파일의 이름이 같으면 두 번째 파일 이름에 괄호 숫자가 붙습니다. 파일을 하나씩 다운로드할 수도 있고 ZIP 압축 파일로 한꺼번에 받을 수도 있습니다. 묶음 안에 암호가 걸린 파일이 있으면 그 파일 차례가 되었을 때 암호를 묻습니다. 건너뛴 파일이나 읽을 수 있는 텍스트가 없는 파일은 변환되지 않은 것으로 표시되고, 나머지 파일은 계속 변환됩니다. 페이지 선택은 PDF를 하나만 변환할 때만 나타나며, 여러 파일을 변환할 때는 모든 페이지가 변환됩니다.
문제 해결
결과가 비어 있거나 텍스트를 찾을 수 없다고 나옵니다. PDF가 스캔본인데 스캔 페이지 옵션이 ‘Skip’으로 되어 있을 가능성이 큽니다. OCR을 선택하고 다시 변환하세요.
OCR 텍스트에 오류가 있습니다. 올바른 언어가 선택되어 있는지 확인하고 높은 정확도 설정을 시도해 보세요. 비뚤어지거나 흐릿한 스캔본은 항상 결과가 떨어집니다.
휴대폰에서 중간에 멈춥니다. 아주 긴 문서는 메모리를 많이 사용합니다. 페이지 범위를 지정해 PDF를 하나씩 변환하거나, 큰 파일은 컴퓨터에서 변환하세요.
파일이 열리지 않습니다. 도구가 손상된 PDF라고 알리면, 아무 PDF 뷰어에서 파일을 열어 인쇄하거나 새 PDF로 저장한 뒤 그 사본으로 다시 시도하세요.
처음부터 안전한 설계
이 변환기는 지금 보고 있는 페이지 안에서 실행되는 스크립트입니다. PDF는 브라우저 메모리로 읽혀 그 안에서 RTF로 바뀌고, 다운로드 형태로 다시 돌려받습니다. 어떤 사본도 서버에 도달하지 않으므로 나중에 지워야 할 저장 데이터도 없습니다. 탭을 닫으면 그대로 사라집니다. 계약서, 진료 서류, 사내 보고서에 알맞은 방식입니다.
자주 묻는 질문
PDF를 RTF로 무료로 변환하려면 어떻게 하나요?
이 페이지에 PDF를 추가하고 ‘Keep formatting’ 또는 ‘Clean document’를 고른 뒤 RTF로 변환 버튼을 누르세요. 계정도, 워터마크도 없고 사용 횟수 제한도 없습니다.
WordPad나 TextEdit에서 RTF 파일을 열 수 있나요?
네. 결과물은 표준 RTF이므로 WordPad, TextEdit, Word, LibreOffice, Pages, Google Docs에서 모두 열립니다. 단순한 편집기는 제목 스타일이나 삽입된 그림 같은 기능을 무시할 수 있습니다.
선택할 수 있는 텍스트가 없는 스캔 PDF도 되나요?
네. 텍스트 레이어가 없는 페이지는 브라우저에서 OCR로 읽을 수 있습니다. 정확도를 높이려면 먼저 문서 언어를 선택하세요. 그런 페이지를 그림으로 유지하거나 건너뛸 수도 있습니다.
PDF의 이미지와 표도 유지되나요?
그림은 RTF에 삽입됩니다. 표는 편집 가능한 표 격자가 아니라 탭 간격이 들어간 텍스트 줄로 옮겨지므로, 편집기에서 정리해야 할 수 있습니다.
PDF의 일부 페이지만 RTF로 변환할 수 있나요?
네. PDF를 하나만 변환할 때는 ‘Pages’ 필드에 2-5나 1, 4, 9-처럼 입력할 수 있습니다. 여러 파일을 변환할 때는 모든 파일의 모든 페이지가 변환됩니다.
기밀 PDF를 여기서 변환해도 안전한가요?
변환은 전적으로 브라우저 안에서 이루어지며 PDF는 서버로 전송되지 않습니다. 입력한 암호도 파일을 여는 데만 기기 안에서 사용됩니다.